AI가 보는 세상은 결국 숫자다: 피지컬 AI(Physical AI)는 몇 개의 모델이 사용되는 걸까?
📌 백스페이스가 없는 물리적 세계의 AI: 텍스트 토큰의 오답을 백스페이스로 지울 수 있는 LLM과 달리, 피지컬 AI의 잘못된 출력은 현실 세계의 물리적 충돌(Crash)로 이어지므로 센서 감각부터 액추에이터 제어까지 완벽한 실시간 무한 루프가 요구됩니다.
📌 단일 두뇌가 아닌 거대한 앙상블 파이프라인: 피지컬 AI는 하나의 거대 모델로 구동되지 않으며, 인지(Perception, 30Hz), 위치 추정(Localization, 50Hz), 예측 및 계획(Prediction/Planning, 10Hz), 제어 정책(Policy/Control, 500~1000Hz) 등 서로 다른 주기를 가진 수십 개의 모델이 릴레이하듯 맞물려 작동합니다.
📌 System 1과 System 2의 속도 조화 및 엣지 AI 실증: 1초에 1~5회 숙고하는 거대 추론 모델(LLM, VLM, VLA, World Model)과 1초에 1000회 즉각 반응하는 반사 제어 모델이 결합된 '텐서의 교향곡' 아키텍처는 자율주행차는 물론 전파 교란(GPS 재밍) 환경의 자율 드론 타격 시스템에 이르기까지 폭넓게 입증되고 있습니다.
1장. 세상을 숫자로 번역하는 마법: LLM과 피지컬 AI의 근본적 차이
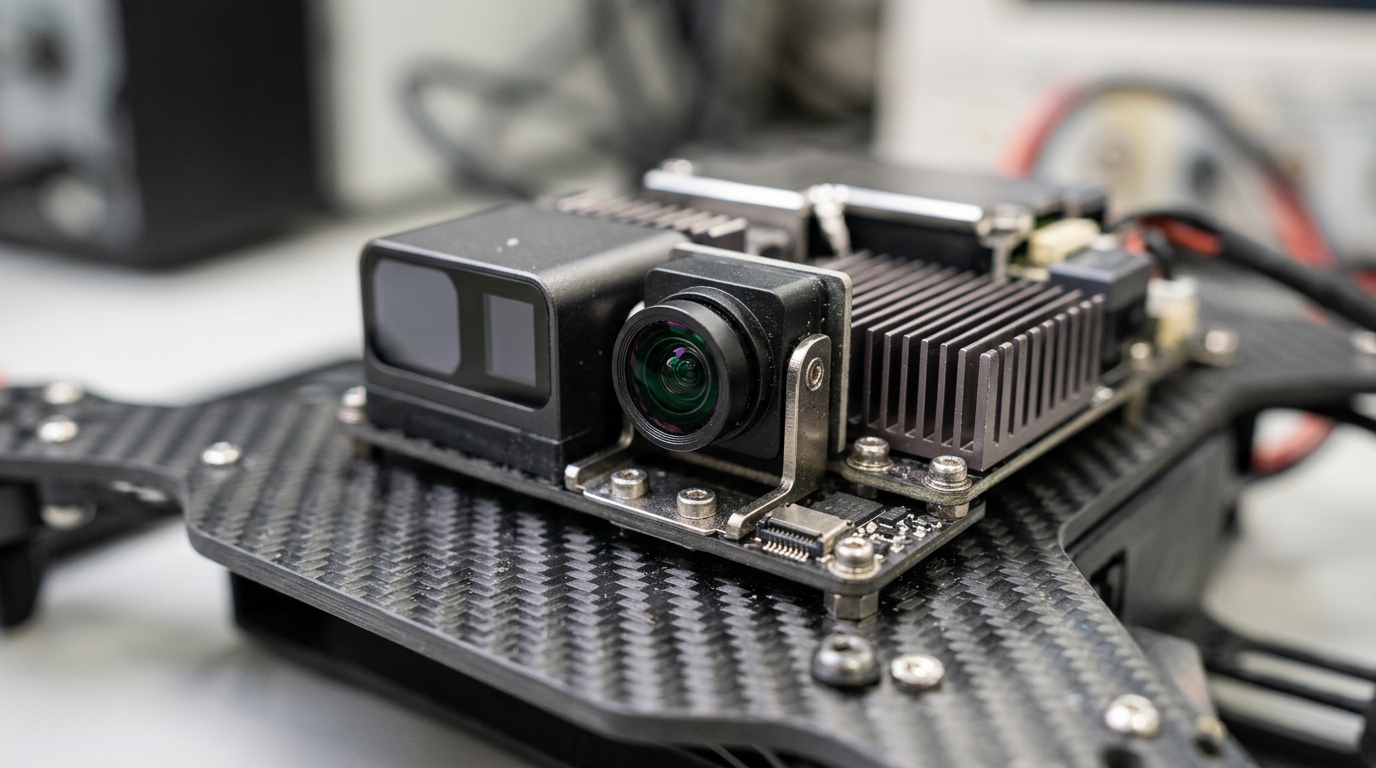
인공지능이 모니터 화면 속 텍스트와 이미지를 생성하는 단계를 넘어 현실의 시공간을 직접 누비는 '피지컬 AI(Physical AI)' 시대로 진입했습니다. 흔히 피지컬 AI라고 하면 인간 형태의 휴머노이드를 먼저 연상하지만, 실제로는 무인 항공기(UAV), 무인 지상 차량(UGV), 무인 선박(USV), 자율주행차, 물류 로봇(AMR), 사족보행 로봇, 산업용 로봇 암, 스마트 전동 휠체어 등 현실과 물리적으로 상호작용하는 모든 자율 시스템을 포괄합니다.
소프트웨어 챗봇(LLM)과 물리적 로봇의 가장 치명적인 차이는 '실행의 비가역성'입니다. 화면 속 잘못된 텍스트 답변은 백스페이스 키로 수정하면 그만이지만, 피지컬 AI의 연산 오류나 액추에이터(모터)의 오작동은 물리적 파손, 인명 피해, 기체 충돌(Crash)이라는 돌이킬 수 없는 현실의 참사로 귀결됩니다.
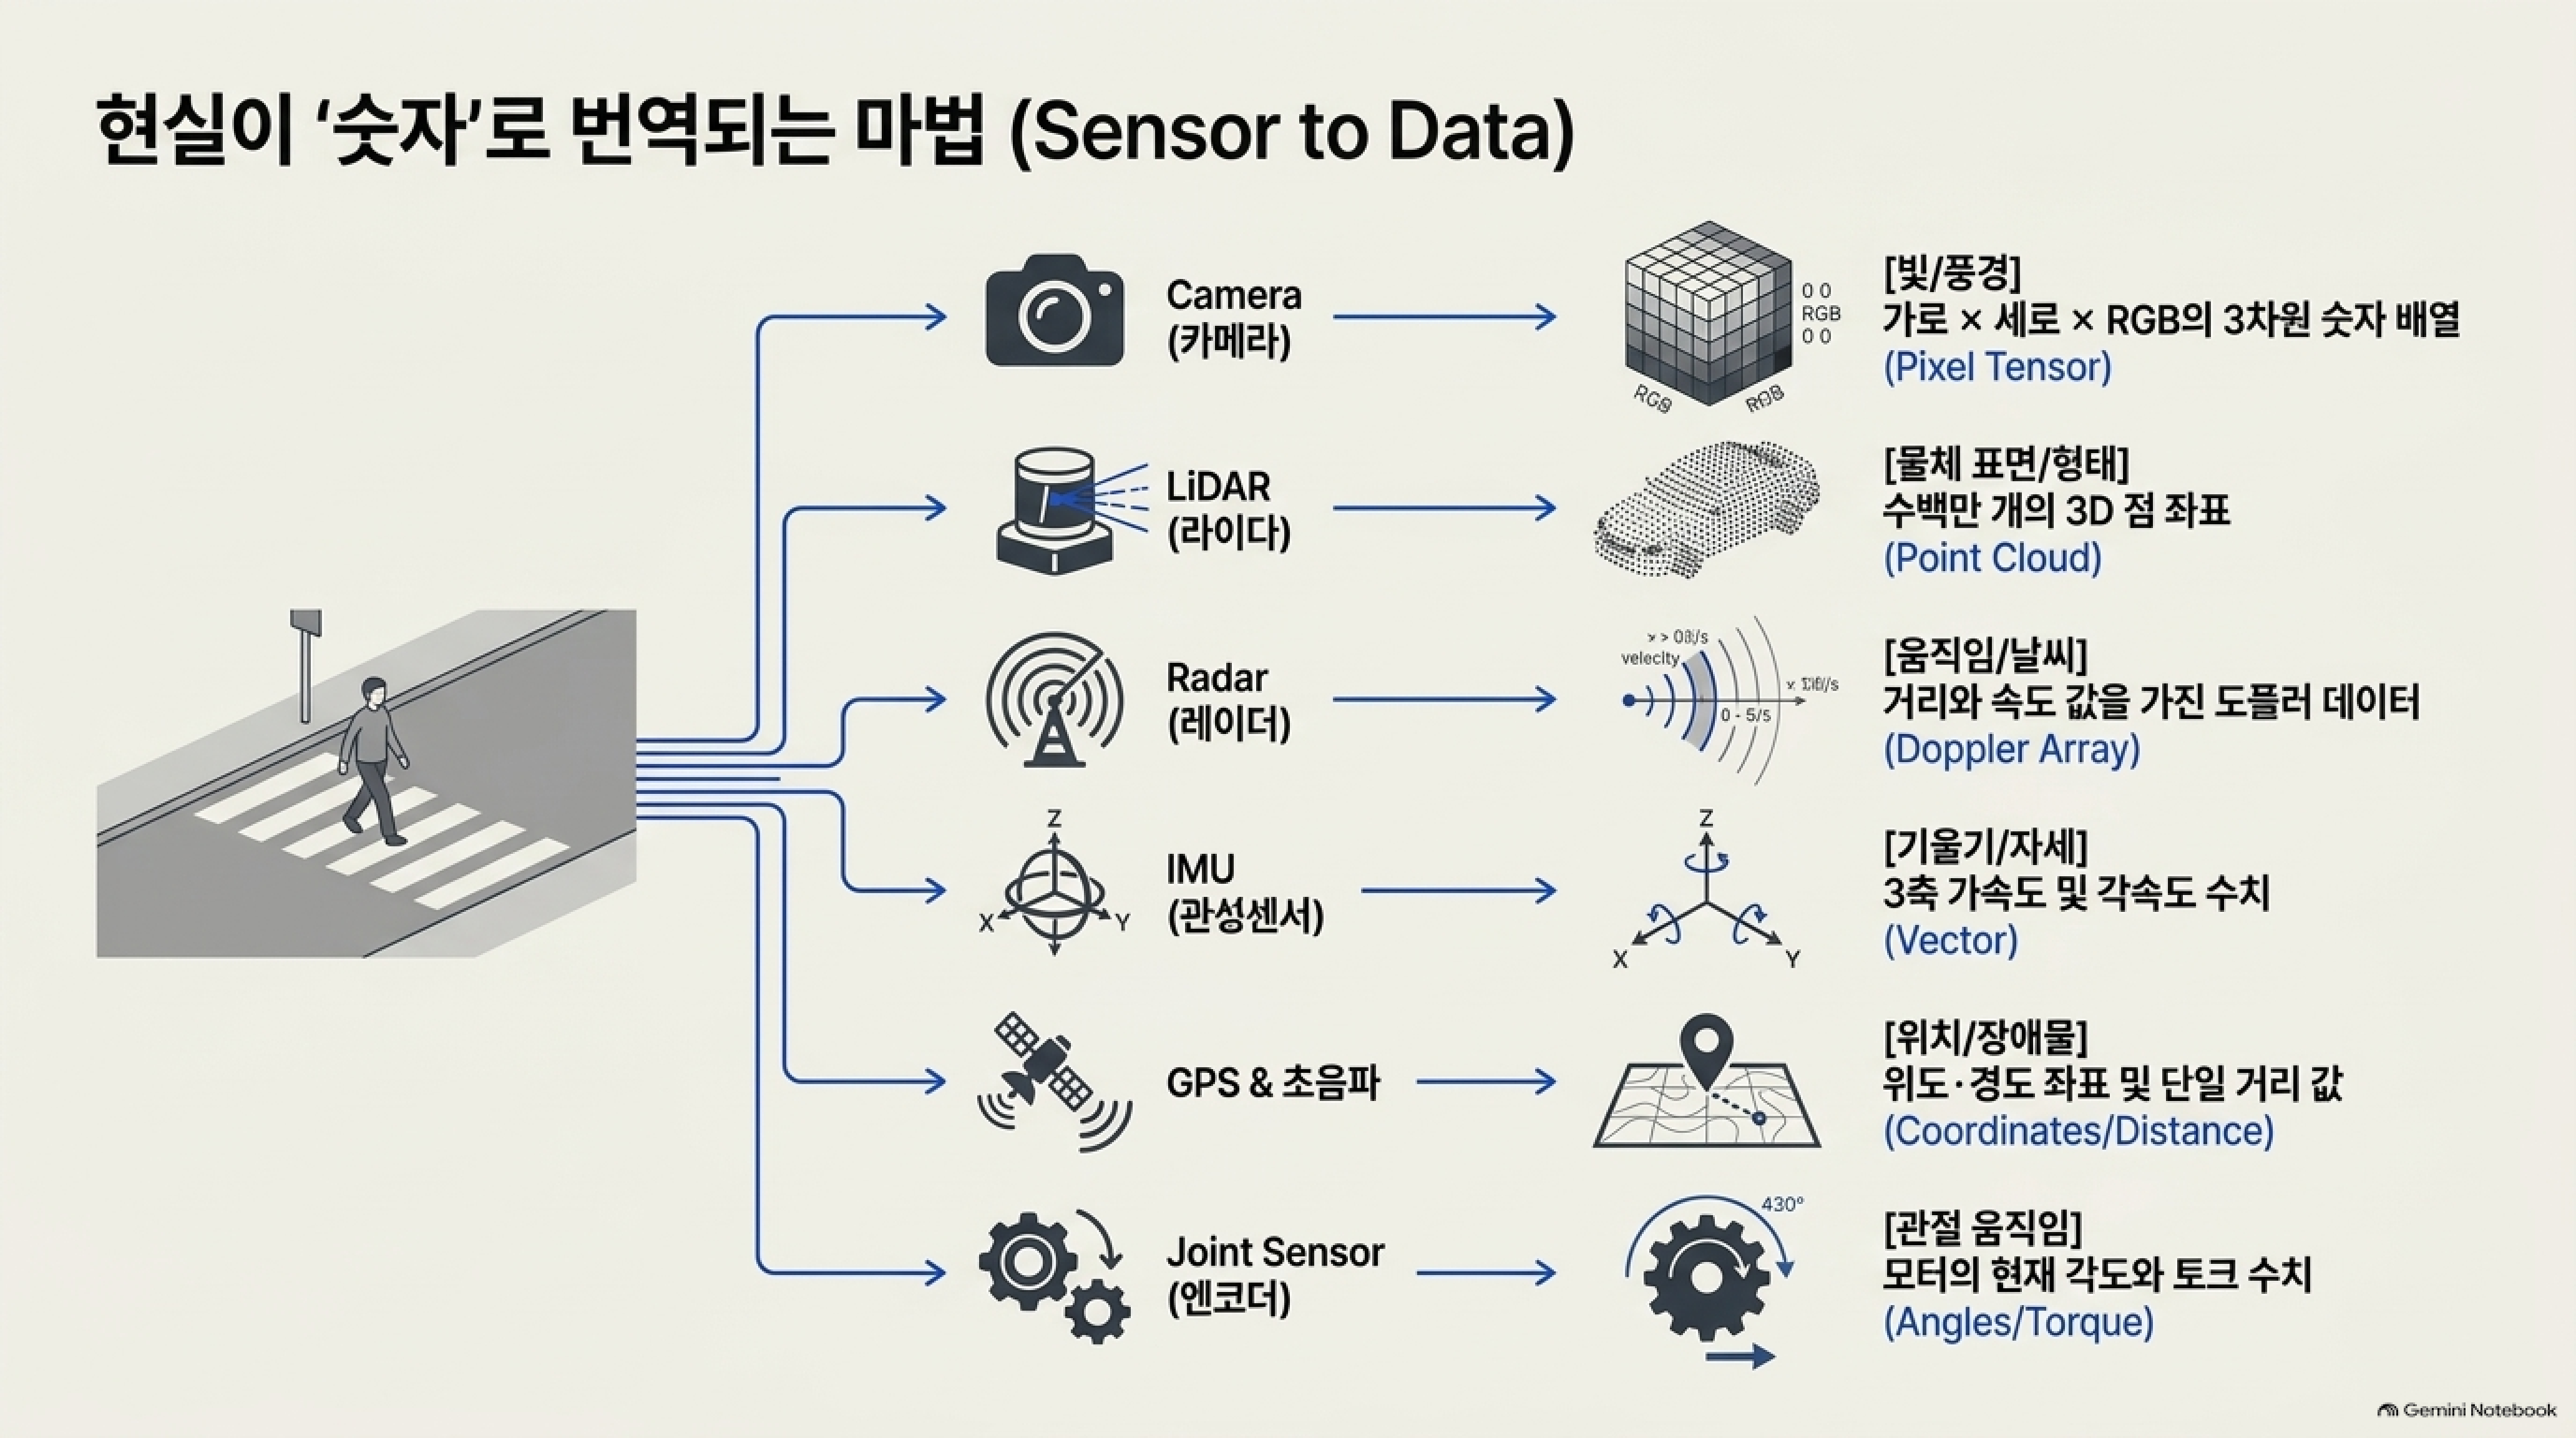
피지컬 AI가 동작하기 위해서는 아날로그 현실 세계를 컴퓨터가 이해할 수 있는 정밀한 디지털 '숫자(텐서)'로 실시간 번역해야 합니다.
카메라(Camera): 가로·세로 격자와 RGB 색상 값으로 구성된 3차원 숫자 배열(Pixel Tensor)로 빛과 시각 풍경을 포착.
라이다(LiDAR): 레이저 반사 시간을 측정해 공간 내 물체 표면의 위치를 수백만 개의 3차원 점 좌표(Point Cloud)로 복원.
레이더(Radar): 도플러 효과를 기반으로 악천후 속에서도 물체의 거리와 이동 속도 수치(Doppler Array)를 산출.
관성센서(IMU): 기체의 3축 가속도와 각속도 수치(Vector)를 읽어 자세와 기울기를 실시간 측정.
GPS 및 초음파: 위도·경도 절대 좌표와 단일 장애물 거리 값을 연속 데이터로 전송.
엔코더(Joint Sensor): 각 관절 모터의 현재 각도와 전달 토크 수치(Angles/Torque)를 피드백.
2장. 단 하나의 뇌는 없다: 인지(Sense)부터 위치 추정(Localization)까지의 앙상블 파이프라인
피지컬 AI 로봇 내부에는 모든 것을 홀로 처리하는 마법 같은 단일 두뇌가 존재하지 않습니다. 수십 개의 세부 인공지능 모델과 수학적 알고리즘이 1초에 수백 번 이상 연산 결과를 교환하는 거대한 앙상블(Ensemble) 파이프라인으로 구성됩니다.
이 연산의 첫 번째 주자는 세상을 뜯어보고 식별하는 인지(Perception) 모델군입니다.
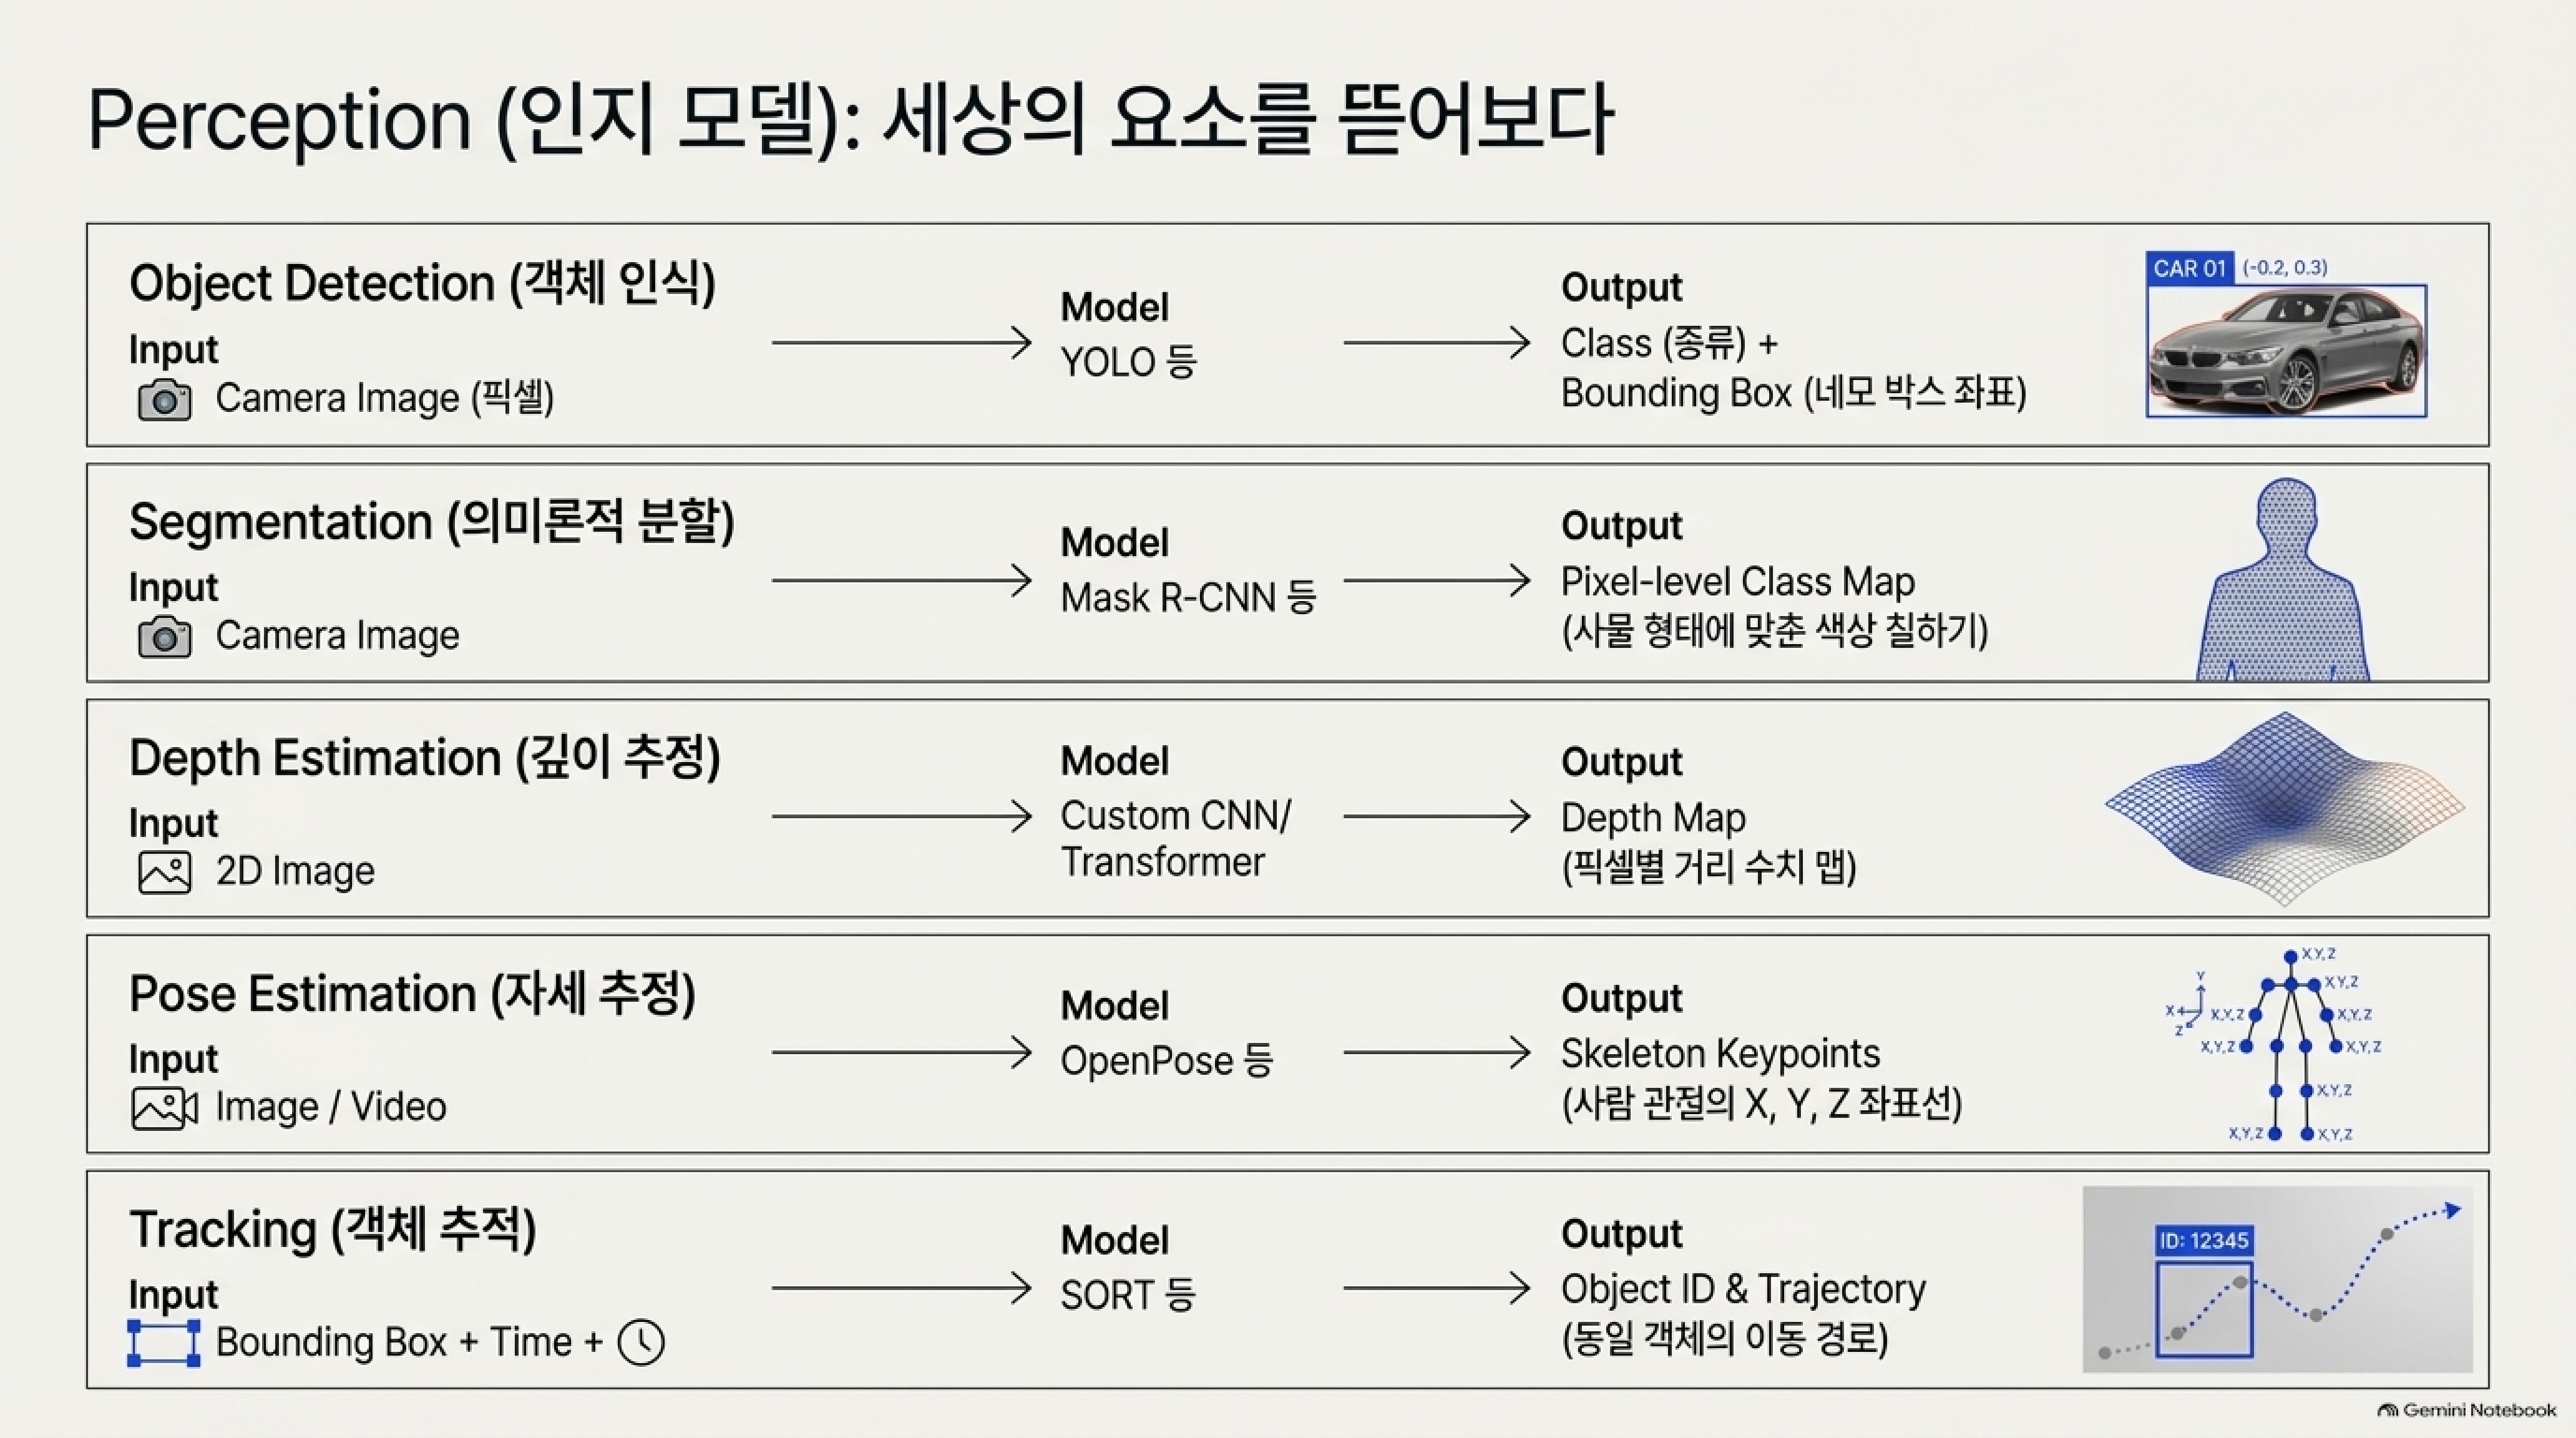
객체 인식(Object Detection): YOLO 등의 경량 합성곱 신경망을 통해 픽셀 이미지에서 물체의 종류(Class)와 2D/3D 경계 상자(Bounding Box) 좌표를 도출.
의미론적 분할(Semantic Segmentation): Mask R-CNN 기반 모델로 도로, 보도블록, 보행자의 영역을 픽셀 단위로 정밀하게 구분.
깊이 추정(Depth Estimation): 2D 단안 카메라 이미지로부터 픽셀별 거리 수치 맵(Depth Map)을 역산.
자세 추정 및 추적(Pose & Tracking): OpenPose 또는 MediaPipe 계열 모델로 보행자의 관절 키포인트를 추출하고, SORT 알고리즘을 결합해 객체 고유 ID와 이동 궤적을 실시간 추적.
이렇게 획득된 다중 센서 데이터는 칼만 필터(Kalman Filter)와 신경망 기반의 센서 퓨전(Sensor Fusion) 깔때기를 거쳐 노이즈가 제거된 '통합 상태 벡터(Unified State Vector)'로 정제됩니다. 이어 SLAM(동시적 위치 추정 및 지도 작성) 알고리즘이 정제된 점군 데이터와 영상, 관성 수치를 결합하여 주변 3차원 지도를 실시간으로 생성함과 동시에 로봇의 정밀한 6자유도 위치(X, Y, Z 및 회전 각도)를 50Hz 주기로 추정해 냅니다.
3장. 1초에 천 번의 연산: System 1과 System 2의 텐서 교향곡
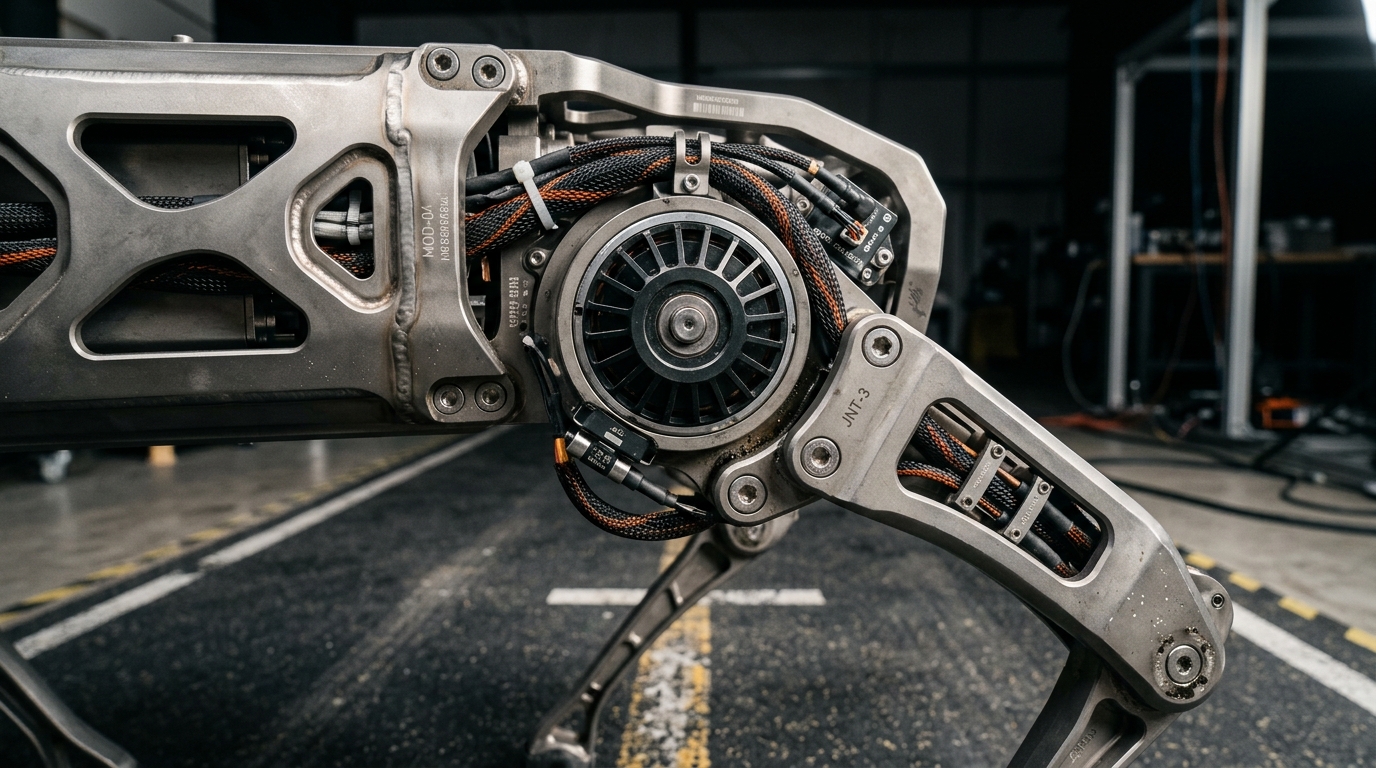
피지컬 AI의 두뇌는 인간의 인지 구조처럼 '깊이 고민하는 느린 뇌(System 2)'와 '반사적으로 대응하는 빠른 뇌(System 1)'가 완벽한 주파수 균형을 이루며 공존합니다.
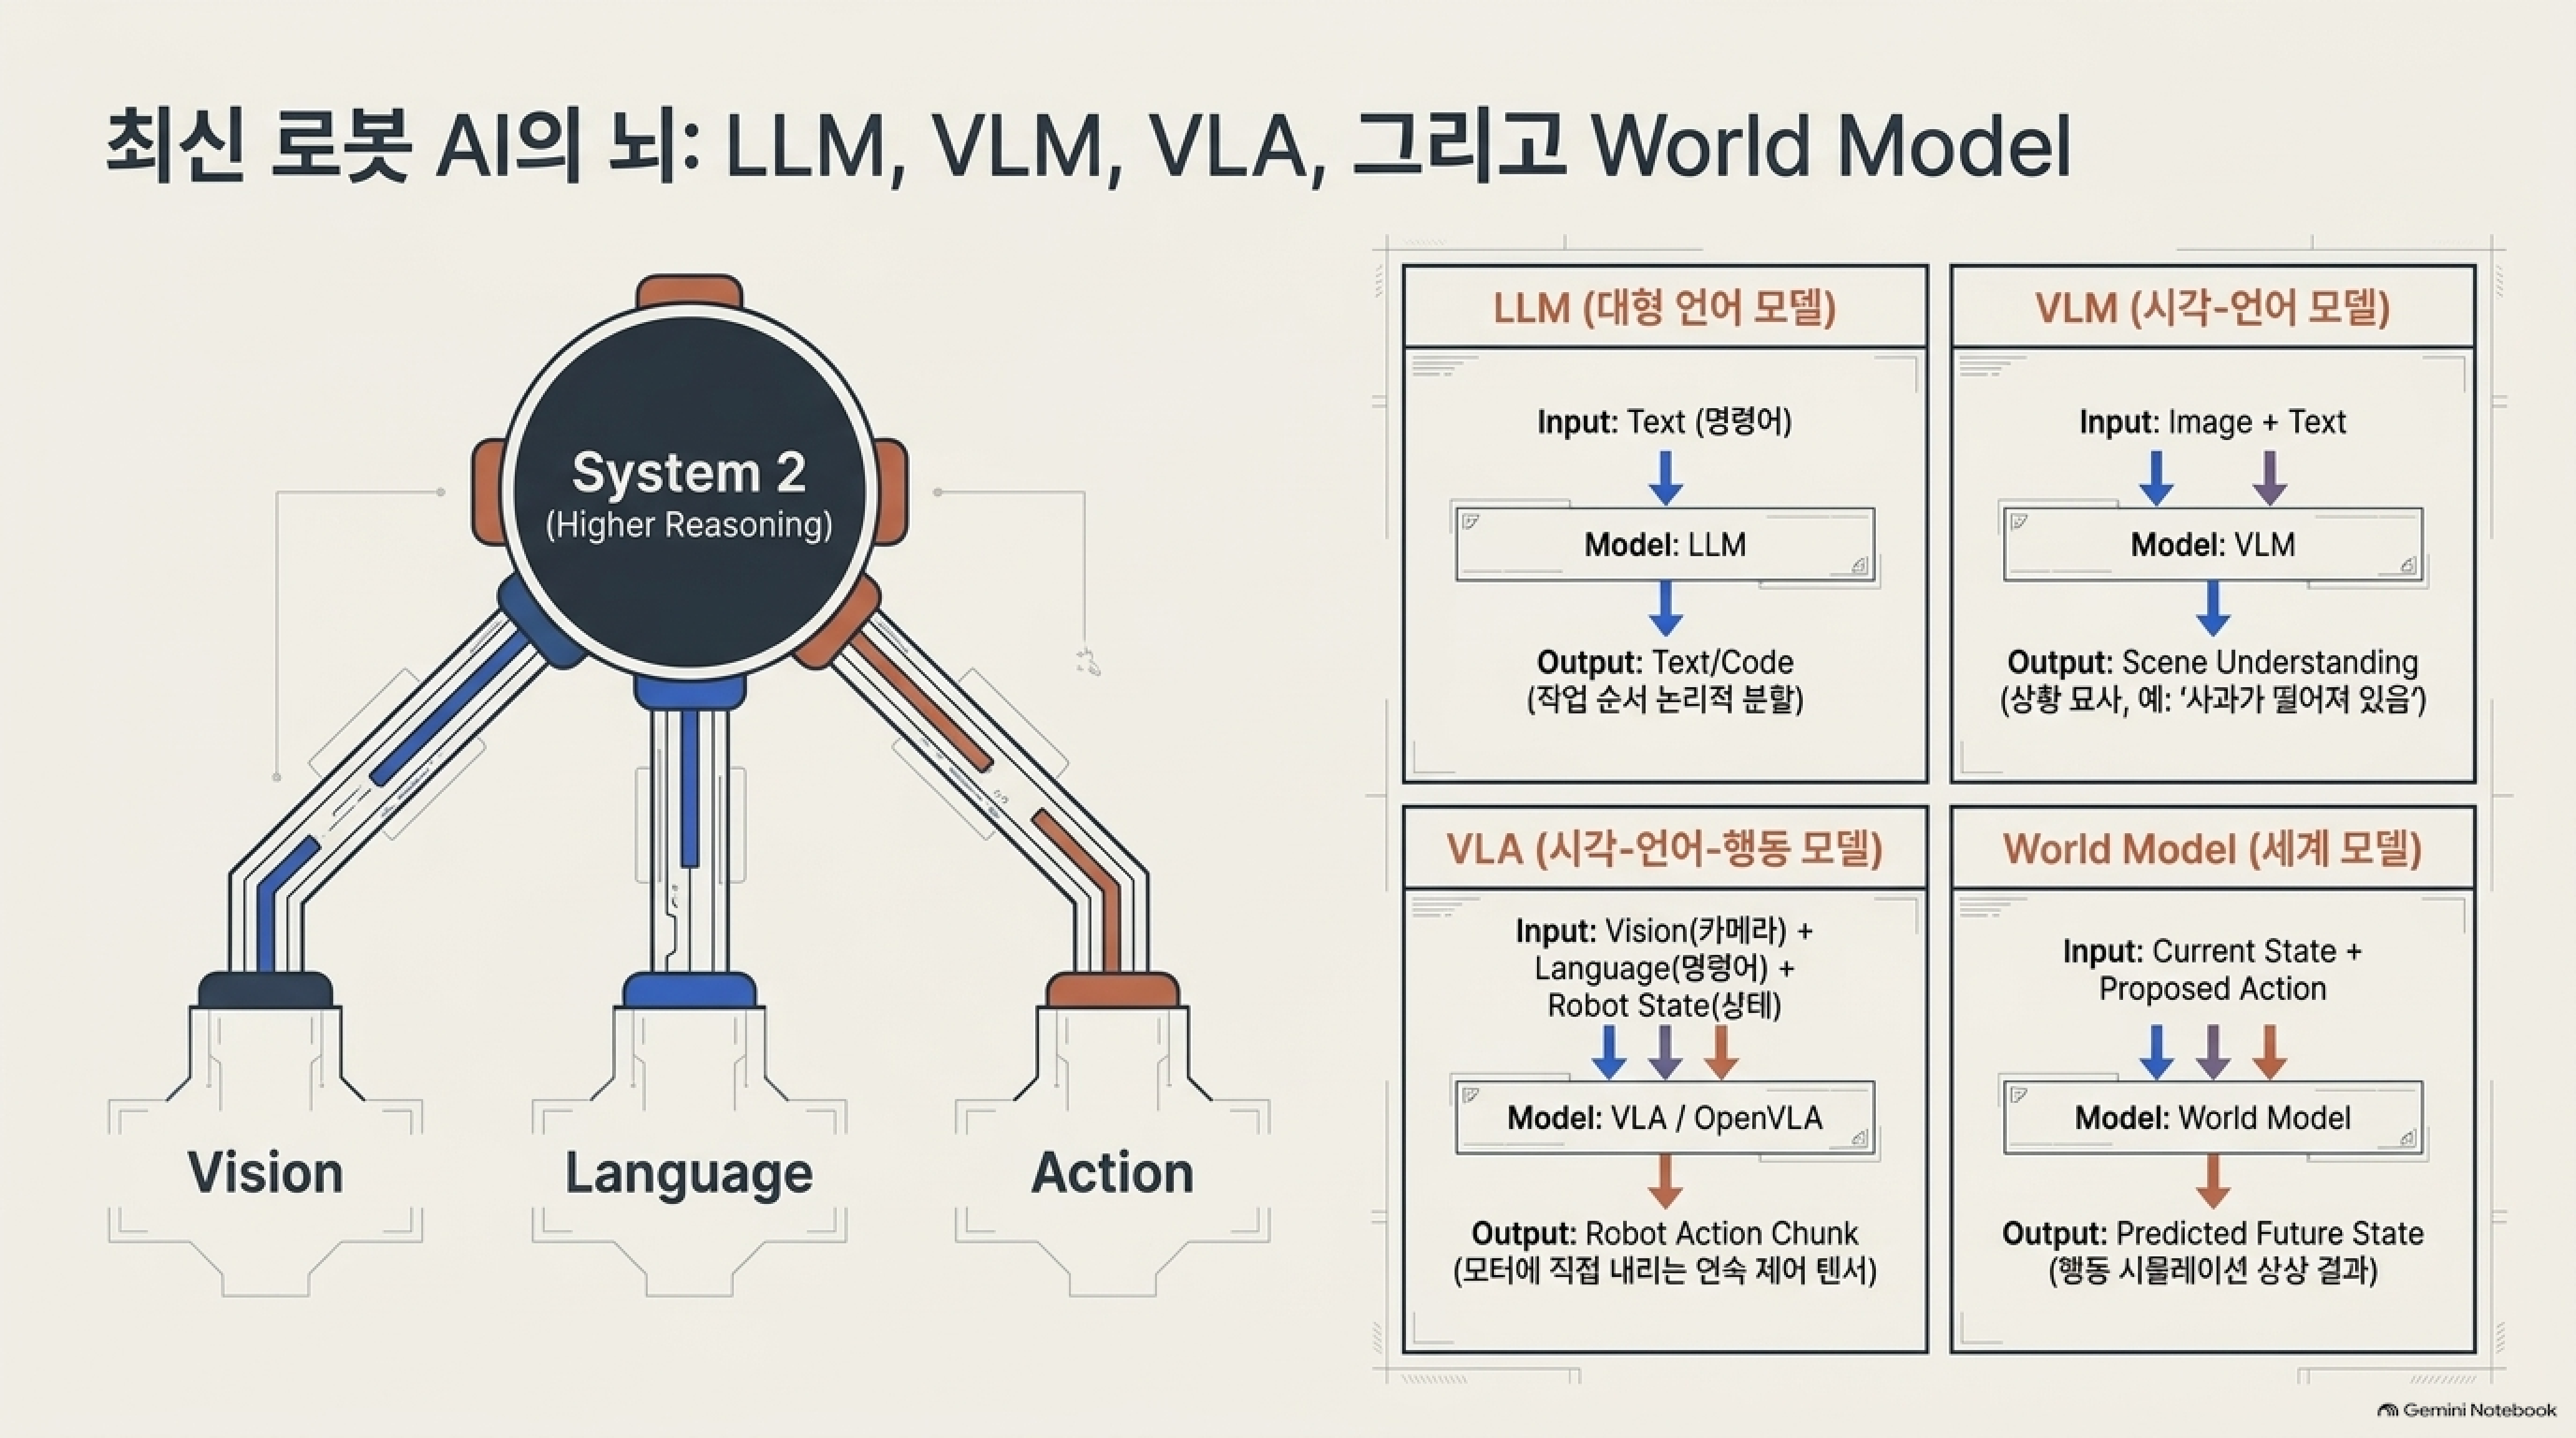
System 2 (Higher Reasoning, 1~5Hz)
전체적인 상황을 이해하고 장기적 행동 목표를 세우는 인지 상위 계층입니다.
LLM 및 VLM: 언어 명령어를 작업 순서 단위로 논리 분할하고, 시각-언어 모델(VLM)을 통해 현장 상황을 종합적으로 묘사·해석.
VLA(Vision-Language-Action): OpenVLA 등 최신 파운데이션 모델을 기반으로 시각 정보와 언어 지시, 로봇 상태를 결합해 모터 제어 텐서의 묶음(Action Chunk)을 다이렉트로 생성.
World Model(세계 모델): "현재 상태에서 이 행동을 취하면 미래에 물리적으로 어떤 일이 일어날 것인가"를 사전에 시뮬레이션하고 상상하여 위험을 회피.
경로 계획(Path Planning): A*, RRT 알고리즘 등을 통해 목적지까지 충돌 없는 최적 이동 점(Waypoints)을 10Hz 주기로 생성.
System 1 (Real-time Control, 500~1000Hz)
물리적 현실 세계는 마찰력, 중력, 바람, 불규칙한 노면 충격이 밀리초 단위로 덮쳐오기 때문에 무거운 거대 모델만으로는 균형을 유지할 수 없습니다.
강화학습 정책(RL Policy)과 밸런스 컨트롤러: 관절 각도와 속도 벡터를 입력받아 각 서보모터에 가해야 할 토크(Torque) 수치를 1초에 500~1000번(Lightning Fast) 계산하여 바닥으로 넘어지지 않고 균형을 유지하도록 반사 신경 역할을 수행.
4장. 전장과 도심을 누비는 엣지 AI: 자율주행차부터 GPS-Denied 드론까지
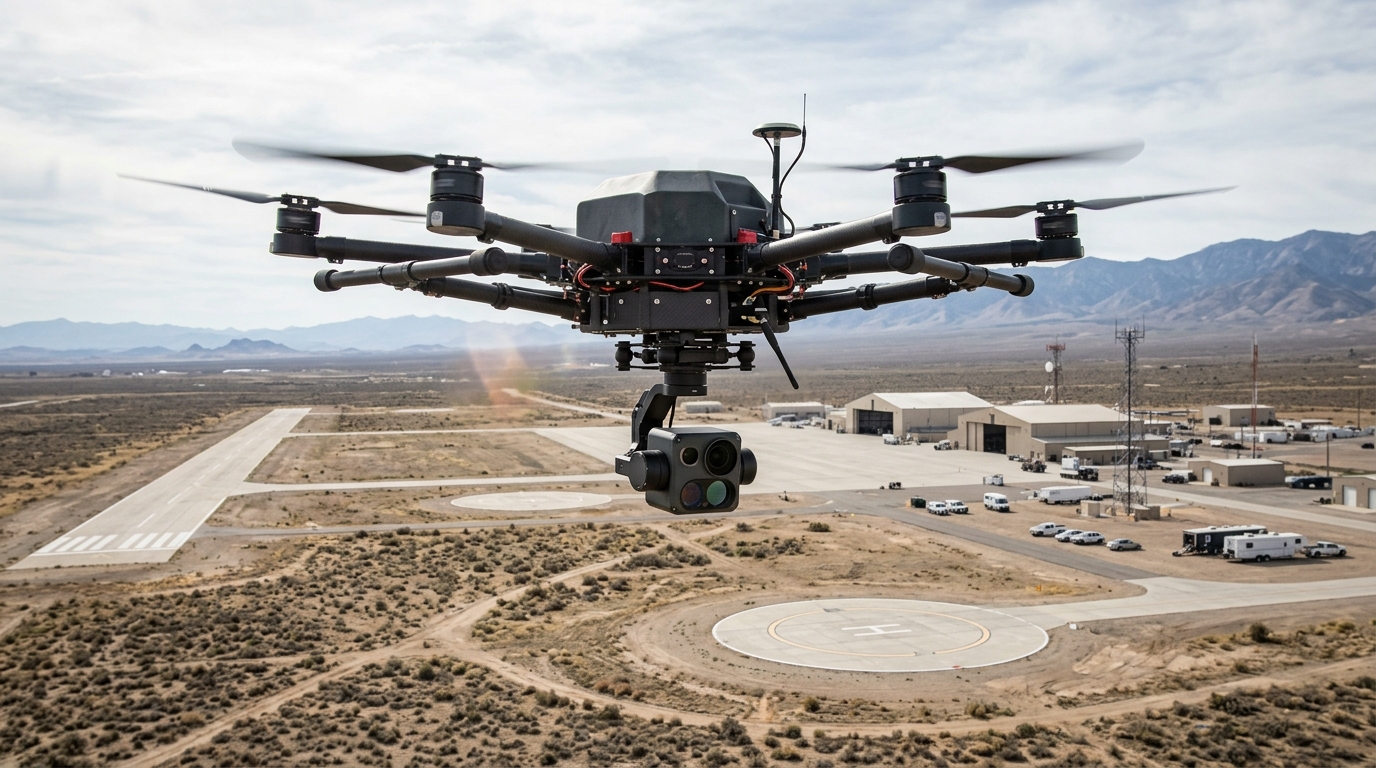
피지컬 AI의 앙상블 조합은 기기의 사용 목적과 작동 환경의 제약 조건에 따라 완전히 다르게 최적화됩니다.
도심 자율주행차 (Waymo 6th Gen 등): 가장 중요한 가치는 완벽한 안전성과 충돌 회피입니다. 13대 이상의 고성능 카메라, 360도 라이다, 레이더 배열을 총동원하는 초정밀 센서 퓨전과, 길을 건너려는 보행자의 3초 뒤 경로를 사전에 계산하는 의도 예측(Prediction) 모델에 컴퓨팅 자원이 집중됩니다.
다목적 휴머노이드 로봇: 복잡한 비정형 환경 속 도구 조작과 작업 수행이 핵심입니다. 사람의 구두 명령을 물리적 조작으로 직결시키는 VLA 모델과 이족 보행의 동적 평형을 유지하는 RL Policy가 핵심 축을 이룹니다.
극한 전장의 자율 타격 드론 (우크라이나 전장 사례): 극심한 전자전으로 인해 위성 GPS 신호와 원격 통신이 완전히 차단되는 재밍 구역(GPS Jamming Zone)을 돌파해야 합니다. 지면 카메라 영상과 IMU 수치만으로 스스로 위치를 계산하는 '시각 주행 거리계(Visual Odometry)' 기반의 비(非)GPS 항법 시스템을 가동하며, 표적을 포착하면 원격 조종수 개입 없이 온보드 엣지 AI(Edge Object Tracking)가 모터를 직접 제어해 종말 유도 타격(Terminal Guidance)을 수행합니다.
피지컬 AI는 결국 센서가 긁어모은 방대한 숫자(텐서) 데이터를 재료로 삼아, 수십 개의 전문 모델이 1초에 수천 번씩 주고받는 정교하고 치열한 연산의 릴레이입니다.
카메라 영상 처리 및 3D 공간 복원(3DGS)부터 온디바이스 AI 임베디드 제어 파이프라인에 이르기까지, 디지털 시각 지능과 물리적 하드웨어가 빈틈없이 결합된 차세대 피지컬 AI 솔루션을 구축해 나가겠습니다.
대표 전화 문의: 1577-7638
공식 이메일: withu@2tv.co.kr
공식 웹사이트: https://visual.center/