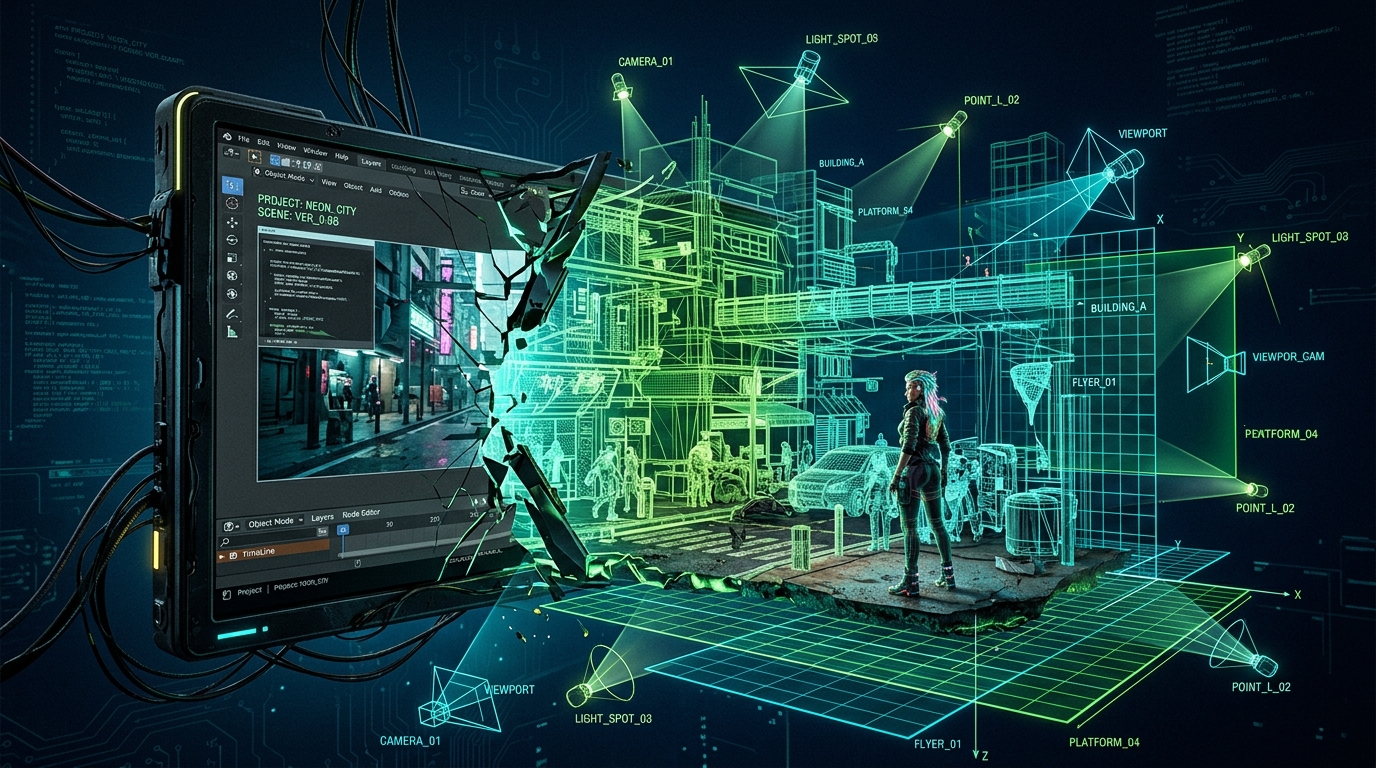
스파게티 밈에서 블렌더 3D 공간으로: AI 영상이 '조작 가능한 세계'로 진화하는 이유
📌 완벽한 픽셀 실사화의 달성: 2023년 기괴한 형태 붕괴를 보였던 스파게티 먹방 AI 영상이 2026년 극사실적 연속성을 확보하며 기술적 비약을 완성했습니다.
📌 프리비즈를 통한 영상 제어의 혁신: 텍스트 프롬프트의 한계를 극복하기 위해 3D 그레이박스(CozyClay)로 카메라와 동선을 먼저 설계하는 프리비즈(Previs) 방식이 도입되었습니다.
📌 편집 가능한 3D 씬 생성으로의 대전환: GPT-6와 블렌더(Blender) 연동을 통해 AI가 단순 픽셀 영상이 아닌 카메라, 조명, 리깅이 남는 3D 공간 자체를 구축하는 '조작 가능한 세계'의 시대가 열렸습니다.
1장. 스파게티 테스트의 비약: 2023년의 픽셀 붕괴에서 2026년의 극사실주의로
2023년 공개된 윌 스미스의 스파게티 먹방 AI 영상은 기괴하게 무너지는 얼굴과 손, 형태를 잃은 국수로 인해 AI 영상 생성의 기술적 한계를 나타내는 대표적인 사례였습니다. 인간에게는 스파게티 한 입을 먹는 지극히 단순한 동작이지만, AI 관점에서는 인물의 표정 유지, 손과 포크 및 음식의 유기적 접촉, 늘어나는 면발의 형태 추적, 프레임 간 일관성 유지라는 복합적인 물리 상호작용이 요구되는 난해한 과제였기 때문입니다.
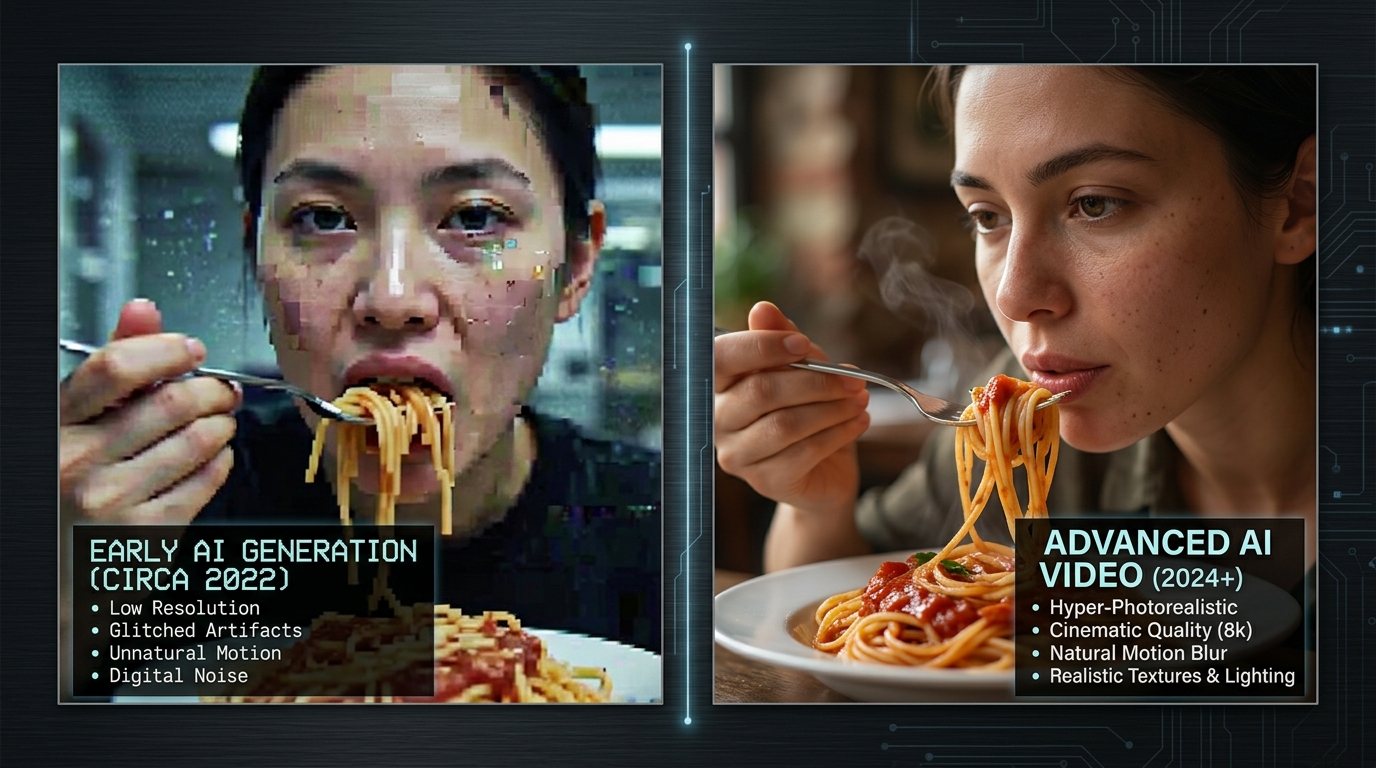
그러나 불과 3년 만에 AI 기술은 비약적인 성장을 이루어 냈습니다. 최근의 AI 영상 모델은 움직임과 인물의 외모, 오브젝트 간 접촉면을 완벽에 가깝게 구현해 내며 실사와 구별하기 힘든 고품질 픽셀을 생성해 냅니다.
하지만 단일 컷을 완벽하게 잘 만드는 것과, 여러 컷이 이어지는 한 편의 완성된 영상을 원하는 연출대로 제작하는 것은 전혀 다른 문제입니다. 컷이 바뀔 때마다 인물의 외모, 의상, 공간의 배치, 카메라 앵글이 조금씩 어긋나는 제어 문제(Control Problem)가 새로운 과제로 부상했습니다.
2장. 프롬프트를 넘어선 프리비즈(Previs)와 카메라 제어 혁신
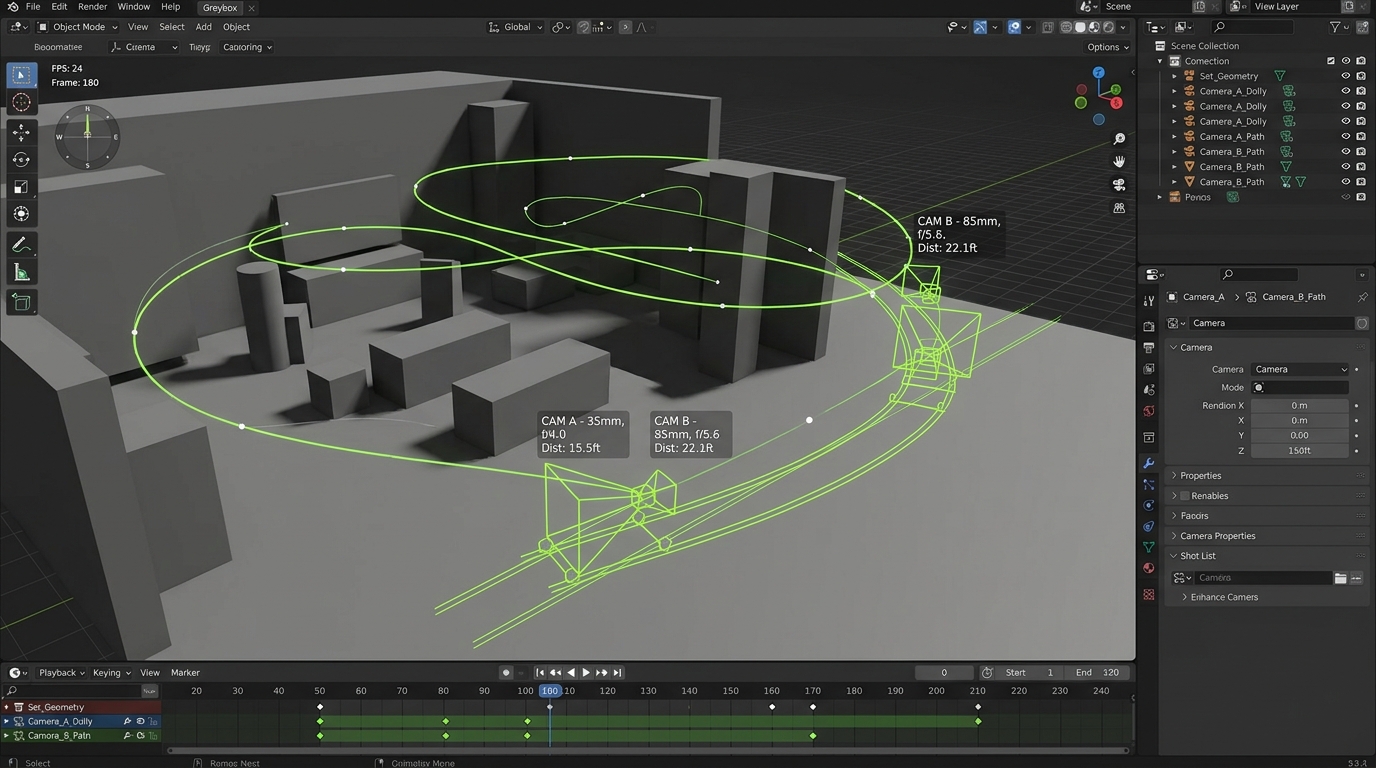
기존의 AI 영상 생성 방식은 "로우앵글로 빠르게 따라가는 돌리 샷"과 같이 텍스트 프롬프트로 카메라 움직임을 수사학적으로 설명하는 데 의존했습니다. 하지만 문장에 의존한 방식은 확률적인 결과물을 반환하므로, 의도한 카메라 구도나 렌즈감을 정확히 고정하기 어려웠습니다.
이러한 한계를 극복하기 위해 등장한 혁신이 바로 3D 그레이박스(Greybox)를 활용한 프리비즈(Previsualization) 기법입니다. CozyClay 사례와 같이 웹 기반 3D 공간에서 인물과 사물의 배치, 카메라 렌즈, 이동 동선을 3D로 먼저 구성한 뒤, 이 가상 촬영 데이터를 AI 영상 모델의 참조 지침으로 전달합니다.
텍스트로 카메라를 묘사하는 대신 카메라 움직임 자체를 3D 데이터로 만들어 넘김으로써, 생성 영상의 연출 통제권을 창작자가 완전히 확보하게 된 것입니다.
3장. 픽셀 생성에서 조작 가능한 3D 씬으로: GPT-6와 블렌더(Blender)의 결합
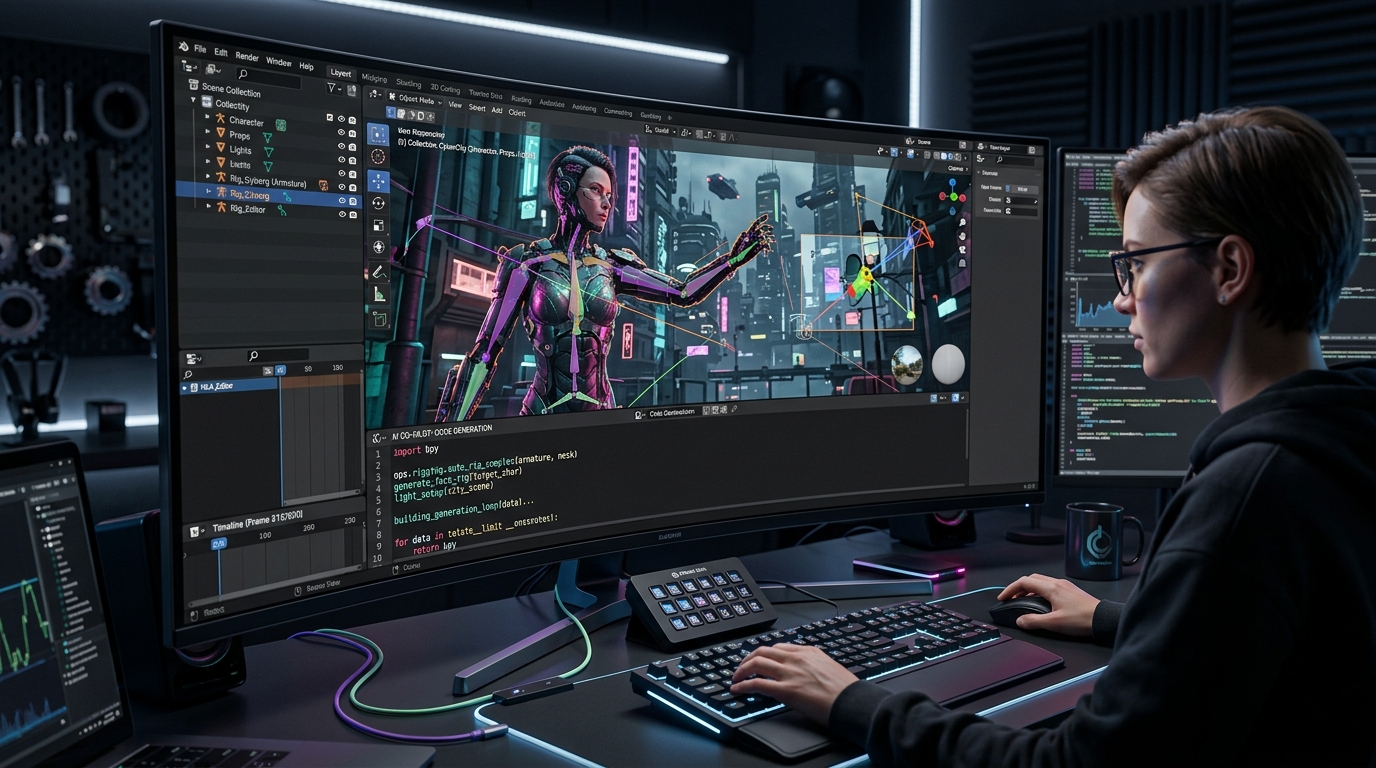
더욱 근본적인 패러다임 전환은 AI가 영상을 출력하는 방식 자체에서 일어나고 있습니다. 기존 방식이 프롬프트를 입력받아 완성된 픽셀 영상만을 뱉어냈다면, 최신 GPT-6 Astra 및 AI 에이전트 환경에서는 프롬프트를 바탕으로 전문 3D 소프트웨어인 블렌더(Blender) 내부에 직접 3D 공간과 카메라, 조명, 리깅, 애니메이션 코드를 구축합니다.
결과물이 단순 픽셀이 아닌 수정 가능한 3D 씬으로 남기 때문에, 연출이나 구도가 마음에 들지 않을 때 영상을 전체 재발주할 필요가 없습니다.
카메라 및 렌즈 제어: 앵글, 초점거리, 이동 경로의 자유로운 재설정 가능
일관성 유지: 동일한 3D 공간 및 자산 기반으로 캐릭터와 소품 배치 관계 완벽 유지
자산의 재활용: 생성된 3D 씬을 Unreal Engine, Three.js, glTF 포맷 등으로 내보내 웹이나 게임 환경에 즉시 재사용
이러한 흐름에 발맞추어 AI 모델이 블렌더를 얼마나 잘 다루는지 평가하는 Blender-Bench 벤치마크가 등장했습니다. GPT-6 Astra, Opus 5 등 프런티어 모델들이 실제 3D 씬을 생성하고 스스로 오류를 수정하는 능력이 평가 대상이 되면서, AI의 경계가 2D 화면을 넘어 3D 공간 제작 능력으로 직결되고 있습니다.
4장. 공간 경험의 미래: AI와 3D가 여는 새로운 비주얼 파이프라인
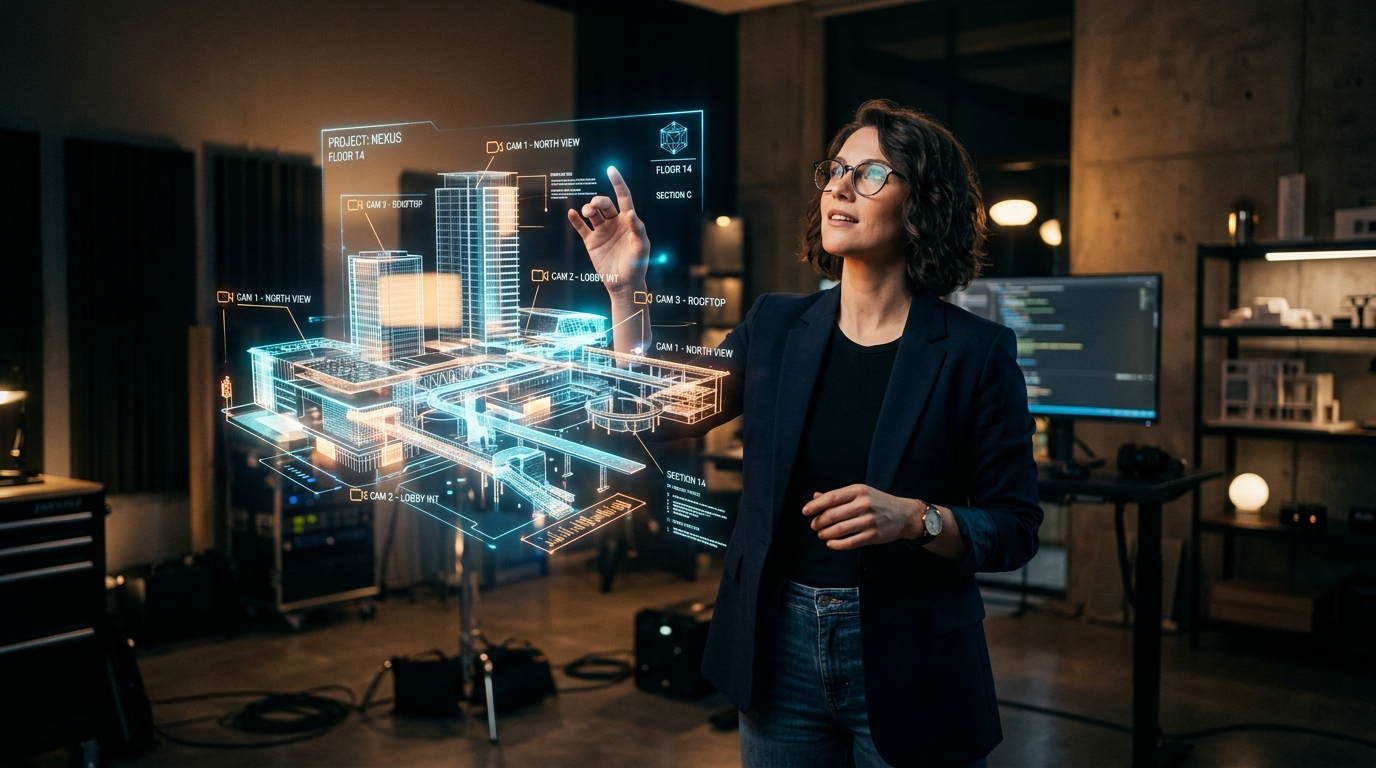
AI 영상의 발전 흐름은 단순한 화질 향상에서 시작해 정밀한 연출 제어, 그리고 조작 가능한 3D 공간의 구축으로 진화해 왔습니다. 스파게티 밈이 AI의 '현실 같은 화면' 구현 능력을 증명해 주었다면, 블렌더와 연동되는 AI 에이전트는 '조작 가능한 세계'의 개막을 알립니다.
3D 공간을 제작하고 수정하는 기술적 문턱과 비용이 낮아짐에 따라, 영상 제작 파이프라인은 물론 웹 가상 전시, 공간 시뮬레이션, 게임, 교육 콘텐츠 전반에 걸쳐 공간 컴퓨팅 기반의 새로운 경험이 신속하게 이식될 것입니다.
최첨단 AI 공간 생성 기술과 3D 디지털 트윈 파이프라인을 연동하여, 기업과 브랜드가 현실의 제약을 넘어 자유롭게 조작하고 확장할 수 있는 고도화된 비주얼 솔루션을 지속적으로 제공해 나가겠습니다.
전화 문의: 1577-7638
공식 이메일: withu@2tv.co.kr
공식 웹사이트: https://visual.center/